
IA y machine learning
Un equipo debe analizar imágenes por sí mismo: en el campo, en el laboratorio o en la máquina. La nube sería cómoda, pero el tiempo de respuesta, la protección de datos y la falta de conexión a la red suelen jugar en su contra. Entonces el procesamiento de imágenes tiene que ejecutarse en un hardware limitado, y es precisamente ahí donde fracasan muchos enfoques que parecían buenos en el PC del desarrollador.
¿Por qué en el equipo?
- Tiempo de respuesta: las decisiones al ritmo de la máquina no admiten un rodeo por la red.
- Disponibilidad: el equipo funciona también sin conexión a Internet.
- Protección de datos: las imágenes de personas o de muestras de pacientes no salen del equipo.
- Costes corrientes: sin tarifas por imagen y sin depender de un proveedor de nube.
La nube sigue teniendo sentido para el entrenamiento, los análisis que abarcan muchos equipos y las actualizaciones. A menudo ha dado buenos resultados este reparto: aprender en el centro de datos, decidir en el equipo.
¿Nube o equipo?
| Criterio | Nube | Hardware embebido |
|---|---|---|
| Tiempo de respuesta | depende de la red | planificable, dentro del ciclo |
| Capacidad de cálculo | escalable prácticamente sin límites | limitada, el modelo tiene que caber |
| Protección de datos | las imágenes salen del equipo | las imágenes se quedan en local |
| Funcionamiento sin red | no es posible | posible |
| Actualización del modelo | central y sencilla | a través del proceso de actualización del equipo |
| Costes | continuos por uso | únicos, para el hardware y la optimización |
El hardware determina el método
Las plataformas embebidas van desde el microcontrolador, pasando por los procesadores ARM, hasta módulos con GPU propia o acelerador de IA. Cada clase tiene límites distintos de memoria, capacidad de cálculo y energía. Por eso, el hardware de destino debe definirse al principio del proyecto, no al final. Una red que funciona con fluidez en una tarjeta gráfica puede ser muchas veces demasiado lenta en un pequeño procesador ARM.
Aligerar los modelos
- Elegir arquitecturas de red más pequeñas, desarrolladas para dispositivos móviles.
- Reducir las imágenes de entrada o analizar solo la región relevante de la imagen.
- Cuantizar: pasar los pesos de números de coma flotante de 32 bits a enteros de 8 bits. Según la documentación de LiteRT de Google (antes TensorFlow Lite), un modelo se vuelve así unas cuatro veces más pequeño y funciona notablemente más rápido en la CPU. La pérdida de precisión suele ser pequeña, pero hay que comprobarla con imágenes reales.
- Utilizar un entorno de ejecución adecuado al hardware, por ejemplo ONNX Runtime, LiteRT o las herramientas del fabricante del chip.
- Anteponer un preprocesamiento clásico para que la red solo tenga que evaluar los casos difíciles.
Medir el tiempo de ejecución en el equipo real
Mida siempre el tiempo de inferencia en el hardware de destino y no solo como valor medio. Para el tiempo de ciclo cuentan también los valores atípicos. Un sencillo script de medición con ONNX Runtime:
import statistics

import time


import numpy as np

import onnxruntime as ort


sitzung = ort.InferenceSession("modell_int8.onnx", providers=["CPUExecutionProvider"])

eingang = sitzung.get_inputs()[0]

form = [d if isinstance(d, int) else 1 for d in eingang.shape]

daten = np.random.rand(*form).astype(np.float32)  # entrada supuesta como float32


for _ in range(10):  # calentamiento

    sitzung.run(None, {eingang.name: daten})


zeiten_ms = []

for _ in range(200):

    start = time.perf_counter()

    sitzung.run(None, {eingang.name: daten})

    zeiten_ms.append((time.perf_counter() - start) * 1000)


p95 = statistics.quantiles(zeiten_ms, n=20)[-1]

print(f"Median {statistics.median(zeiten_ms):.1f} ms, 95 %: {p95:.1f} ms")
A ello se suman la captación de la imagen, el preprocesamiento y la entrega del resultado. Solo la suma muestra si se cumple el tiempo de ciclo.
De la práctica: encontrar rostros sin una IA de cálculo intensivo
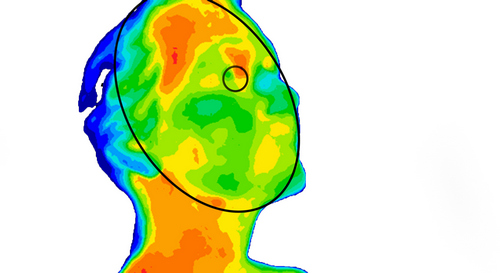
Un fabricante de cámaras termográficas quería medir la temperatura corporal de las personas. Para ello, la cámara tenía que encontrar primero la posición de los rostros en la imagen, no la identidad de las personas. El software se ejecutaba en un sistema embebido con una capacidad de cálculo muy limitada, y las lámparas y otras fuentes de calor perturbaban la detección. Analizamos algoritmos y redes neuronales en cuanto a velocidad y calidad de detección. El resultado fueron métodos propios y ligeros que distinguen de forma fiable los rostros de otras fuentes de calor y funcionan en tiempo real en el hardware embebido. La lección: inteligencia en el equipo no significa automáticamente red neuronal en el equipo.
Errores típicos
- Desarrollar un modelo en el PC y llevarlo al hardware de destino solo al final.
- Medir solo la inferencia, no toda la cadena desde la toma hasta el resultado.
- Cuantizar sin volver a comprobar después la precisión con imágenes reales.
- Pasar por alto la necesidad de memoria y la generación de calor en funcionamiento continuo.
- No prever una vía para actualizar los modelos en el campo.
- Utilizar redes neuronales donde un método clásico ligero sería más rápido y robusto.
Cómo le ayudamos
- Estudio de viabilidad de procesamiento de imágenes: comprobamos qué método funciona en su hardware de destino dentro del tiempo de ciclo exigido, con mediciones del tiempo de ejecución en el equipo real.
- Implementación: procesamiento de imágenes para sistemas embebidos en C++, C# y Python, desde la conexión de la cámara y los controladores hasta la entrega con documentación y código fuente.
- Su proyecto: Solicite su proyecto o concierte una primera conversación
- Caso de estudio: Cámaras termográficas: encontrar rostros con un hardware limitado
De nuestros proyectos: detección de rostros en cámaras termográficas con hardware embebido, controladores en tiempo real para cámaras termográficas. Fuentes especializadas: LiteRT: cuantización posterior al entrenamiento, ONNX Runtime: cuantización.
 kununu