
IA et machine learning
Un appareil doit analyser lui-même des images – sur le terrain, au laboratoire ou sur la machine. Le cloud serait pratique, mais le temps de réponse, la protection des données et l'absence de connexion réseau plaident souvent contre. Le traitement d'images doit alors tourner sur un matériel limité, et c'est précisément là qu'échouent de nombreuses approches qui semblaient bonnes sur le PC du développeur.
Pourquoi sur l'appareil ?
- Temps de réponse : les décisions à la cadence de la machine ne tolèrent pas de détour par le réseau.
- Disponibilité : l'appareil fonctionne aussi sans connexion Internet.
- Protection des données : les images de personnes ou d'échantillons de patients ne quittent pas l'appareil.
- Coûts courants : pas de frais par image et pas de dépendance à un fournisseur de cloud.
Le cloud reste pertinent pour l'entraînement, les analyses portant sur de nombreux appareils et les mises à jour. Cette répartition a souvent fait ses preuves : apprendre au centre de données, décider sur l'appareil.
Cloud ou appareil ?
| Critère | Cloud | Matériel embarqué |
|---|---|---|
| Temps de réponse | dépend du réseau | prévisible, à la cadence voulue |
| Puissance de calcul | évolutive pratiquement sans limite | limitée, le modèle doit tenir |
| Protection des données | les images quittent l'appareil | les images restent en local |
| Fonctionnement sans réseau | impossible | possible |
| Mise à jour du modèle | centralisée et simple | via le processus de mise à jour de l'appareil |
| Coûts | récurrents, à l'usage | uniques, pour le matériel et l'optimisation |
Le matériel détermine la méthode
Les plateformes embarquées vont du microcontrôleur aux modules dotés de leur propre GPU ou d'un accélérateur d'IA, en passant par les processeurs ARM. Chaque catégorie a d'autres limites en matière de mémoire, de puissance de calcul et d'énergie. C'est pourquoi le matériel cible doit être défini au début du projet, et non à la fin. Un réseau qui tourne de façon fluide sur une carte graphique peut être beaucoup trop lent sur un petit processeur ARM.
Alléger les modèles
- Choisir des architectures de réseau plus petites, développées pour les appareils mobiles.
- Réduire les images d'entrée ou n'analyser que la partie pertinente de l'image.
- Quantifier : convertir les poids de nombres à virgule flottante 32 bits en entiers 8 bits. Selon la documentation de LiteRT de Google (anciennement TensorFlow Lite), un modèle devient ainsi environ quatre fois plus petit et tourne nettement plus vite sur le CPU. La perte de précision est généralement faible, mais doit être vérifiée avec de vraies images.
- Utiliser un environnement d'exécution adapté au matériel, par exemple ONNX Runtime, LiteRT ou les outils du fabricant de la puce.
- Placer en amont un prétraitement classique, afin que le réseau n'ait plus à évaluer que les cas difficiles.
Mesurer le temps d'exécution – sur l'appareil réel
Mesurez toujours le temps d'inférence sur le matériel cible et pas seulement en moyenne. Pour la cadence, les valeurs aberrantes comptent aussi. Un script de mesure simple avec ONNX Runtime :
import statistics

import time


import numpy as np

import onnxruntime as ort


sitzung = ort.InferenceSession("modell_int8.onnx", providers=["CPUExecutionProvider"])

eingang = sitzung.get_inputs()[0]

form = [d if isinstance(d, int) else 1 for d in eingang.shape]

daten = np.random.rand(*form).astype(np.float32)  # entrée supposée en float32


for _ in range(10):  # préchauffage

    sitzung.run(None, {eingang.name: daten})


zeiten_ms = []

for _ in range(200):

    start = time.perf_counter()

    sitzung.run(None, {eingang.name: daten})

    zeiten_ms.append((time.perf_counter() - start) * 1000)


p95 = statistics.quantiles(zeiten_ms, n=20)[-1]

print(f"Median {statistics.median(zeiten_ms):.1f} ms, 95 %: {p95:.1f} ms")
S'y ajoutent l'acquisition d'images, le prétraitement et la transmission du résultat. Seule la somme montre si la cadence est tenue.
Retour d'expérience : trouver des visages sans IA gourmande en calcul
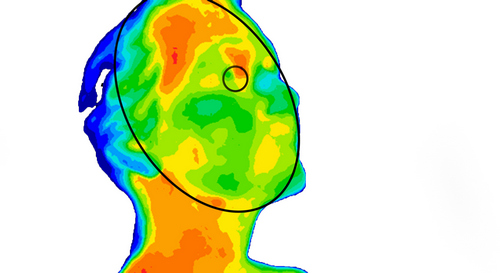
Un fabricant de caméras thermiques voulait mesurer la température corporelle de personnes. Pour cela, la caméra devait d'abord trouver la position des visages dans l'image – pas l'identité des personnes. Le logiciel tournait sur un système embarqué à la puissance de calcul très limitée, et les lampes et autres sources de chaleur perturbaient la détection. Nous avons examiné des algorithmes et des réseaux de neurones sous l'angle de la vitesse et de la qualité de détection. Le résultat : des méthodes propres et légères, qui distinguent de manière fiable les visages des autres sources de chaleur et tournent en temps réel sur le matériel embarqué. La leçon : intelligence sur l'appareil ne signifie pas automatiquement réseau de neurones sur l'appareil.
Erreurs typiques
- Développer un modèle sur le PC et ne le porter sur le matériel cible qu'à la fin.
- Ne mesurer que l'inférence, et non toute la chaîne, de l'acquisition au résultat.
- Quantifier sans revérifier ensuite la précision avec de vraies images.
- Négliger les besoins en mémoire et l'échauffement en fonctionnement continu.
- Ne prévoir aucun moyen de mettre à jour le modèle sur le terrain.
- Utiliser des réseaux de neurones là où une méthode classique légère serait plus rapide et plus robuste.
Comment nous vous aidons
- Étude de faisabilité en traitement d'images : nous vérifions quelle méthode tourne sur votre matériel cible à la cadence exigée – avec des mesures du temps d'exécution sur l'appareil réel.
- Mise en œuvre : traitement d'images pour systèmes embarqués en C++, C# et Python, de la connexion de la caméra et des pilotes jusqu'à la remise avec documentation et code source.
- Votre projet : Demander un projet ou convenir d'un premier entretien
- Étude de cas : Caméras thermiques : trouver des visages sur un matériel limité
Tiré de nos projets : reconnaissance faciale sur caméras thermiques avec matériel embarqué, pilotes temps réel pour caméras de thermographie. Sources spécialisées : LiteRT – quantification post-entraînement, ONNX Runtime – quantification.
 kununu