
IA e machine learning
Un dispositivo deve analizzare da sé le immagini – sul campo, in laboratorio o sulla macchina. Il cloud sarebbe comodo, ma tempi di risposta, protezione dei dati e assenza di connessione di rete spesso lo sconsigliano. Allora l'elaborazione delle immagini deve girare su hardware limitato, ed è proprio lì che falliscono molti approcci che sul PC dello sviluppatore sembravano funzionare bene.
Perché sul dispositivo?
- Tempi di risposta: le decisioni alla cadenza della macchina non tollerano una deviazione attraverso la rete.
- Disponibilità: il dispositivo funziona anche senza connessione a Internet.
- Protezione dei dati: le immagini di persone o di campioni di pazienti non lasciano il dispositivo.
- Costi correnti: nessuna tariffa per immagine e nessuna dipendenza da un fornitore cloud.
Il cloud resta utile per l'addestramento, le analisi su molti dispositivi e gli aggiornamenti. Spesso si è dimostrata valida questa suddivisione: apprendere nel data center, decidere sul dispositivo.
Cloud o dispositivo?
| Criterio | Cloud | Hardware embedded |
|---|---|---|
| Tempi di risposta | dipendenti dalla rete | pianificabili, in cadenza |
| Potenza di calcolo | scalabile praticamente a piacere | limitata, il modello deve adattarsi |
| Protezione dei dati | le immagini lasciano il dispositivo | le immagini restano in locale |
| Funzionamento senza rete | non possibile | possibile |
| Aggiornamento del modello | centrale e semplice | tramite il processo di aggiornamento del dispositivo |
| Costi | correnti, in base all'uso | una tantum per hardware e ottimizzazione |
È l'hardware a determinare il metodo
Le piattaforme embedded vanno dal microcontrollore ai processori ARM fino a moduli con GPU propria o acceleratore IA. Ogni classe ha limiti diversi di memoria, potenza di calcolo ed energia. Per questo l'hardware di destinazione va definito all'inizio del progetto, non alla fine. Una rete che gira in modo fluido su una scheda grafica può essere molte volte troppo lenta su un piccolo processore ARM.
Rendere snelli i modelli
- Scegliere architetture di rete più piccole, sviluppate per dispositivi mobili.
- Ridurre le immagini in ingresso o analizzare solo la porzione di immagine rilevante.
- Quantizzare: convertire i pesi da numeri in virgola mobile a 32 bit in interi a 8 bit. Secondo la documentazione di LiteRT di Google (in precedenza TensorFlow Lite), un modello diventa così circa quattro volte più piccolo e gira sulla CPU in modo nettamente più veloce. La perdita di precisione è per lo più ridotta, ma va verificata con immagini reali.
- Usare un ambiente di runtime adatto all'hardware, ad esempio ONNX Runtime, LiteRT o gli strumenti del produttore del chip.
- Anteporre una pre-elaborazione classica, in modo che la rete debba valutare solo i casi difficili.
Misurare i tempi di esecuzione – sul dispositivo reale
Misuri il tempo di inferenza sempre sull'hardware di destinazione e non solo come valore medio. Per la cadenza contano anche i valori anomali. Un semplice script di misura con ONNX Runtime:
import statistics

import time


import numpy as np

import onnxruntime as ort


sitzung = ort.InferenceSession("modell_int8.onnx", providers=["CPUExecutionProvider"])

eingang = sitzung.get_inputs()[0]

form = [d if isinstance(d, int) else 1 for d in eingang.shape]

daten = np.random.rand(*form).astype(np.float32)  # ingresso ipotizzato come float32


for _ in range(10):  # riscaldamento

    sitzung.run(None, {eingang.name: daten})


zeiten_ms = []

for _ in range(200):

    start = time.perf_counter()

    sitzung.run(None, {eingang.name: daten})

    zeiten_ms.append((time.perf_counter() - start) * 1000)


p95 = statistics.quantiles(zeiten_ms, n=20)[-1]

print(f"Median {statistics.median(zeiten_ms):.1f} ms, 95 %: {p95:.1f} ms")
A ciò si aggiungono acquisizione dell'immagine, pre-elaborazione e trasmissione del risultato. Solo la somma mostra se la cadenza viene rispettata.
Dalla pratica: trovare volti senza un'IA ad alto consumo di calcolo
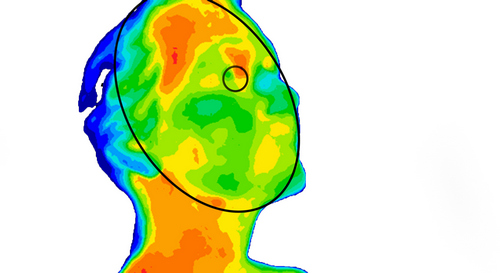
Un produttore di termocamere voleva misurare la temperatura corporea delle persone. Per farlo la telecamera doveva prima trovare la posizione dei volti nell'immagine – non l'identità delle persone. Il software girava su un sistema embedded con potenza di calcolo fortemente limitata, e lampade e altre fonti di calore disturbavano il riconoscimento. Abbiamo esaminato algoritmi e reti neurali in termini di velocità e qualità di riconoscimento. Il risultato sono stati metodi propri e snelli, che distinguono in modo affidabile i volti da altre fonti di calore e girano in tempo reale sull'hardware embedded. La lezione: intelligenza sul dispositivo non significa automaticamente rete neurale sul dispositivo.
Errori tipici
- Sviluppare un modello sul PC e portarlo sull'hardware di destinazione solo alla fine.
- Misurare solo l'inferenza, non l'intera catena dall'acquisizione al risultato.
- Quantizzare senza verificare di nuovo la precisione con immagini reali.
- Trascurare il fabbisogno di memoria e lo sviluppo di calore nel funzionamento continuo.
- Non prevedere un modo per aggiornare i modelli sul campo.
- Impiegare reti neurali dove un metodo classico snello sarebbe più veloce e più robusto.
Come La aiutiamo
- Studio di fattibilità per l'elaborazione delle immagini: verifichiamo quale metodo gira sul Suo hardware di destinazione alla cadenza richiesta – con misure dei tempi di esecuzione sul dispositivo reale.
- Realizzazione: elaborazione delle immagini per sistemi embedded in C++, C# e Python, dal collegamento di telecamera e driver fino alla consegna con documentazione e codice sorgente.
- Il Suo progetto: Richieda un progetto o fissi un primo colloquio
- Caso di studio: Termocamere: trovare volti con hardware limitato
Dai nostri progetti: riconoscimento facciale su termocamere con hardware embedded, driver in tempo reale per termocamere. Fonti specialistiche: LiteRT – quantizzazione post-addestramento, ONNX Runtime – quantizzazione.
 kununu