
KI und Machine Learning
Ein Gerät soll Bilder selbst auswerten – im Feld, im Labor oder an der Maschine. Die Cloud wäre bequem, doch Reaktionszeit, Datenschutz und fehlende Netzverbindung sprechen oft dagegen. Dann muss die Bildverarbeitung auf knapper Hardware laufen, und genau dort scheitern viele Ansätze, die auf dem Entwickler-PC gut aussahen.
Warum auf dem Gerät?
- Reaktionszeit: Entscheidungen im Maschinentakt vertragen keinen Umweg über das Netz.
- Verfügbarkeit: Das Gerät arbeitet auch ohne Internetverbindung.
- Datenschutz: Bilder von Personen oder Patientenproben verlassen das Gerät nicht.
- Laufende Kosten: keine Gebühren je Bild und keine Abhängigkeit von einem Cloud-Anbieter.
Die Cloud bleibt sinnvoll für Training, Auswertungen über viele Geräte hinweg und Updates. Bewährt hat sich oft diese Aufteilung: lernen im Rechenzentrum, entscheiden auf dem Gerät.
Cloud oder Gerät?
| Kriterium | Cloud | Embedded-Hardware |
|---|---|---|
| Reaktionszeit | abhängig vom Netz | planbar, im Takt |
| Rechenleistung | praktisch frei skalierbar | begrenzt, das Modell muss passen |
| Datenschutz | Bilder verlassen das Gerät | Bilder bleiben lokal |
| Betrieb ohne Netz | nicht möglich | möglich |
| Modellaktualisierung | zentral und einfach | über den Update-Prozess des Geräts |
| Kosten | laufend je Nutzung | einmalig für Hardware und Optimierung |
Die Hardware bestimmt das Verfahren
Embedded-Plattformen reichen vom Mikrocontroller über ARM-Prozessoren bis zu Modulen mit eigener GPU oder KI-Beschleuniger. Jede Klasse hat andere Grenzen bei Speicher, Rechenleistung und Energie. Deshalb gehört die Zielhardware an den Anfang des Projekts, nicht ans Ende. Ein Netz, das auf einer Grafikkarte flüssig läuft, kann auf einem kleinen ARM-Prozessor um ein Vielfaches zu langsam sein.
Modelle schlank machen
- Kleinere Netzarchitekturen wählen, die für mobile Geräte entwickelt wurden.
- Eingangsbilder verkleinern oder nur den relevanten Bildausschnitt auswerten.
- Quantisieren: Gewichte von 32-Bit-Gleitkommazahlen auf 8-Bit-Ganzzahlen umstellen. Laut Dokumentation von Googles LiteRT (früher TensorFlow Lite) wird ein Modell so etwa viermal kleiner und läuft auf der CPU deutlich schneller. Der Genauigkeitsverlust ist meist gering, muss aber mit echten Bildern geprüft werden.
- Eine Laufzeitumgebung nutzen, die zur Hardware passt, etwa ONNX Runtime, LiteRT oder die Werkzeuge des Chipherstellers.
- Klassische Vorverarbeitung vorschalten, damit das Netz nur noch die schwierigen Fälle bewerten muss.
Laufzeit messen – auf dem echten Gerät
Messen Sie die Inferenzzeit immer auf der Zielhardware und nicht nur als Mittelwert. Für den Takt zählen auch Ausreißer. Ein einfaches Messskript mit ONNX Runtime:
import statistics
import time

import numpy as np
import onnxruntime as ort

sitzung = ort.InferenceSession("modell_int8.onnx", providers=["CPUExecutionProvider"])
eingang = sitzung.get_inputs()[0]
form = [d if isinstance(d, int) else 1 for d in eingang.shape]
daten = np.random.rand(*form).astype(np.float32)  # Eingang als float32 angenommen

for _ in range(10):  # Aufwärmen
    sitzung.run(None, {eingang.name: daten})

zeiten_ms = []
for _ in range(200):
    start = time.perf_counter()
    sitzung.run(None, {eingang.name: daten})
    zeiten_ms.append((time.perf_counter() - start) * 1000)

p95 = statistics.quantiles(zeiten_ms, n=20)[-1]
print(f"Median {statistics.median(zeiten_ms):.1f} ms, 95 %: {p95:.1f} ms")
Hinzu kommen Bildaufnahme, Vorverarbeitung und Ergebnisübergabe. Erst die Summe zeigt, ob der Takt hält.
Aus der Praxis: Gesichter finden ohne rechenintensive KI
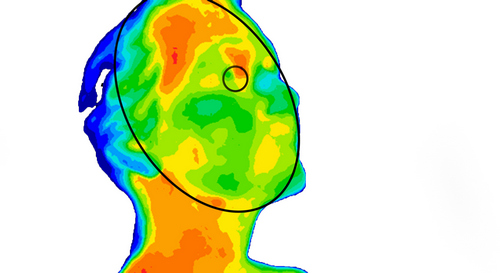
Ein Hersteller von Wärmebildkameras wollte die Körpertemperatur von Menschen messen. Dafür musste die Kamera zuerst die Lage der Gesichter im Bild finden – nicht die Identität der Personen. Die Software lief auf einem eingebetteten System mit stark begrenzter Rechenleistung, und Lampen und andere Wärmequellen störten die Erkennung. Wir haben Algorithmen und neuronale Netze auf Tempo und Erkennungsqualität untersucht. Das Ergebnis waren eigene, schlanke Verfahren, die Gesichter zuverlässig von anderen Wärmequellen unterscheiden und in Echtzeit auf der eingebetteten Hardware laufen. Die Lehre: Intelligenz auf dem Gerät heißt nicht automatisch neuronales Netz auf dem Gerät.
Typische Fehler
- Ein Modell auf dem PC entwickeln und erst zum Schluss auf die Zielhardware bringen.
- Nur die Inferenz messen, nicht die ganze Kette von der Aufnahme bis zum Ergebnis.
- Quantisieren, ohne die Genauigkeit danach mit echten Bildern erneut zu prüfen.
- Speicherbedarf und Wärmeentwicklung im Dauerbetrieb übersehen.
- Keinen Weg für Modell-Updates im Feld vorsehen.
- Neuronale Netze einsetzen, wo ein schlankes klassisches Verfahren schneller und robuster wäre.
So helfen wir
- Machbarkeitsstudie Bildverarbeitung: Wir prüfen, welches Verfahren auf Ihrer Zielhardware im geforderten Takt läuft – mit Laufzeitmessungen auf dem echten Gerät.
- Umsetzung: Bildverarbeitung für eingebettete Systeme in C++, C# und Python, von der Kamera- und Treiberanbindung bis zur Übergabe mit Dokumentation und Quellcode.
- Ihr Projekt: Projekt anfragen oder Erstgespräch vereinbaren
- Fallstudie: Wärmebildkameras: Gesichter finden auf knapper Hardware
Aus unseren Projekten: Gesichtserkennung auf Wärmebildkameras mit eingebetteter Hardware, Echtzeit-Treiber für Thermografiekameras. Fachquellen: LiteRT – Post-Training-Quantisierung, ONNX Runtime – Quantisierung.
 kununu